Errores comunes en proyectos de automatización (y cómo evitarlos desde el diseño)
La automatización promete lo que toda operación busca: mayor throughput, menos errores, mejor nivel de servicio, menor dependencia de mano de obra y una ejecución más predecible. En papel, todo cuadra. En el piso, no siempre.
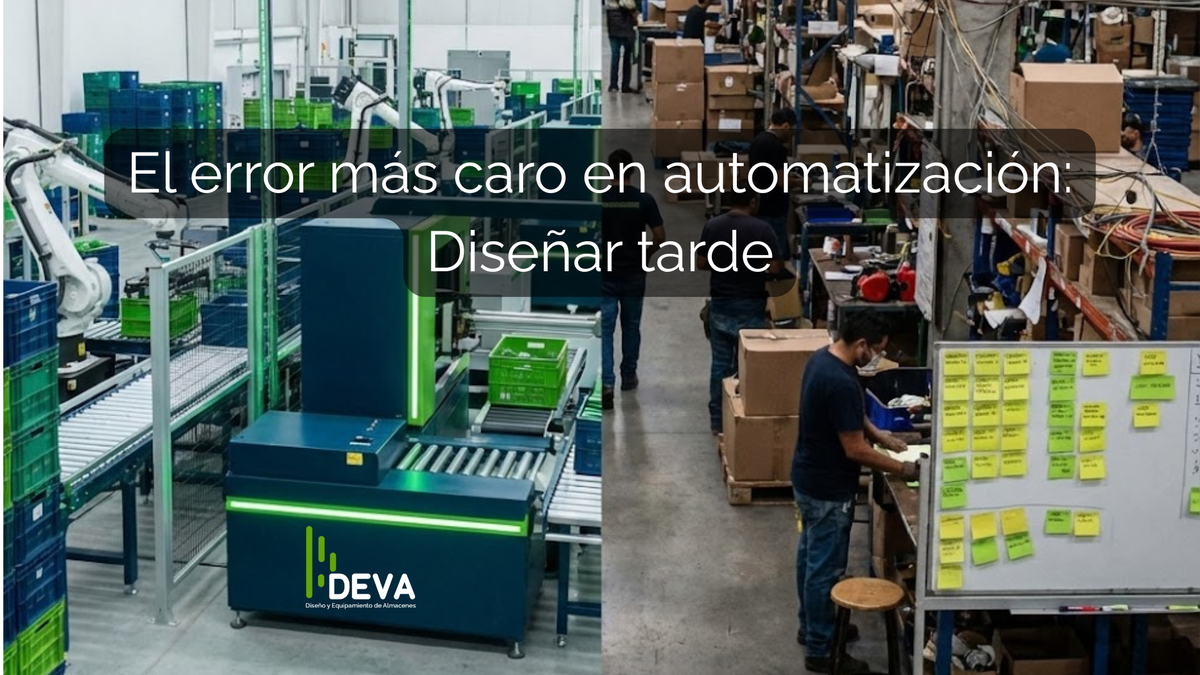
Con frecuencia, proyectos que inician con entusiasmo terminan convertidos en “islas” de tecnología: equipos subutilizados, flujos interrumpidos, usuarios que regresan al Excel y un ROI que se estira hasta volverse difícil de defender. Y en la mayoría de los casos, el problema no es la tecnología. El problema es el orden. Se diseña tarde lo que debió diseñarse primero.
La idea central es clara: el éxito o el fracaso de un proyecto de automatización se decide en la fase de diseño. Cuando el diseño es sólido, la implementación es ejecución. Cuando el diseño es débil, la implementación se transforma en una cadena de parches, cambios no planeados y costos ocultos.
A continuación se presentan los errores más comunes (y más caros) en México y Latinoamérica, junto con su impacto típico y el enfoque práctico para prevenirlos desde el diseño.
El primer error: automatizar el caos (digitalizar un proceso que ya estaba roto)
En muchas operaciones mexicanas existe una habilidad admirable para “sacar el día” aunque haya informalidad: reglas no documentadas, prioridades que cambian con una llamada, decisiones que viven en WhatsApp y dependencias críticas en una o dos personas que “se saben el truco”. El problema aparece cuando ese caos se pretende automatizar sin estabilizarlo. El sistema no va a ordenar mágicamente lo que no está ordenado: lo va a replicar… pero más rápido.
El resultado es predecible: la automatización amplifica el error. Aparecen retrabajos, se multiplican los “casos especiales”, TI o ingeniería terminan apagando incendios y el ROI se empieza a diluir en costos operativos que nadie presupuestó.
La salida no es heroica, es metodológica. En diseño, hay que tomar una decisión incómoda pero sana: diseñar sobre proceso estándar, no sobre excepciones. Mapear el flujo real, no el procedimiento “ideal” y cuantificar variaciones. Si hoy una decisión depende de una persona y no de una regla, ese es el primer foco rojo.
El segundo error: diseñar para el promedio, no para los picos (ni para la operación real)
Una de las maneras más rápidas de subdimensionar un sistema es dimensionar con promedios. Promedio por hora, por turno, por día. Pero el almacén no vive en promedio: vive en picos. Cierres de mes, promociones, ventanas de embarque, llegadas simultáneas, cambios de mix, urgencias, prioridades de última hora. Y en México eso se agrava con variabilidad de proveedores, tráfico, atrasos y ajustes operativos al vuelo.
¿La consecuencia? Saturación, colas, tiempos muertos y, tarde o temprano, la operación regresando al modo manual “para sacar el día”. Para dirección, esto se ve como lo peor: capex invertido para crear un cuello de botella. Para el piso, se siente como presión, estrés y pérdida de confianza en el sistema.
Desde diseño, el antídoto es pensar por escenarios: normal, pico, pico extremo y contingencia. Y aceptar algo que a veces cuesta negociar: buffers intencionales (espacio, capacidad, ventanas y reglas). Un sistema robusto no es el que “funciona en un día bonito”; es el que no se rompe cuando el día se pone real.
El tercer error: comprar equipo antes de definir el sistema (la trampa de la “solución estrella”)
“Vimos un sorter increíble”. “Nos ofrecieron un AS/RS con gran descuento”. “Ese AMR se ve espectacular”. Este es uno de los errores más caros porque suele nacer de una buena intención: avanzar rápido. Pero elegir tecnología antes de cerrar ingeniería conceptual (flujos, reglas, interfaces, layout, seguridad, mantenimiento, gobierno de datos) es apostar el proyecto a una pieza sin tener la arquitectura completa.
Luego llegan las sorpresas: integraciones costosas, cambios de layout, reingeniería tardía y el peor escenario: un punto único de falla que condiciona toda la operación. Y entonces el ROI deja de depender del negocio… y se vuelve rehén de un equipo mal ubicado o mal integrado.
El orden correcto es el que casi nadie quiere escuchar al inicio: primero el sistema, luego la tecnología. Objetivos, restricciones, flujos y arquitectura (WMS/WES/WCS + equipos). Y después sí, seleccionar contra requerimientos, con criterios claros de medición. Porque si mañana ese equipo se detiene, la pregunta no es “si pasa”, sino qué tan preparada está tu operación para seguir funcionando.
El cuarto error: subestimar el lado humano (la adopción no se decreta)
La resistencia al cambio no se elimina con un kickoff. En el piso, si el sistema “estorba”, la operación lo rodea. Y en muchos almacenes el conocimiento está en la gente, no en el proceso. Si el diseño no incorpora usabilidad, entrenamiento realista y roles claros, el proyecto nace con fricción.
Eso se traduce en baja adopción, atajos operativos, errores por confusión, dependencia de “los que sí le saben” y rotación. Para C-Level, es un costo oculto: productividad que no aparece en el modelo financiero. Para Operaciones, es frustración y desgaste.
La gran diferencia la hace una decisión en diseño: diseñar la operación futura con los usuarios (supervisión, mantenimiento, seguridad, planeación), simular tareas reales y construir SOPs simples. La pregunta incómoda que salva proyectos es: “¿cómo se ve un turno cuando el experto no está?” Si la respuesta es “se nos cae”, aún estás a tiempo de corregir.
El quinto error: “después vemos” mantenimiento y refacciones
La máquina puede ser excelente, pero si no existe un plan serio de mantenimiento preventivo, refacciones críticas definidas y capacidades internas entrenadas, el sistema se vuelve frágil. Y en México, además, pesan temas muy concretos: importaciones, aduanas, tiempos de entrega, disponibilidad real de soporte.
Cuando esto se ignora, aparecen paros recurrentes, costos de urgencia y disponibilidad menor a la esperada. El ROI se erosiona por OPEX y, peor, por pérdida de servicio.
Aquí el diseño vuelve a ser el seguro: mantenimiento desde ingeniería conceptual (preventivo, predictivo, correctivo, SLA, stock crítico), diseño de accesos y seguridad para mantenimiento, y un plan claro para operar cuando falle un componente crítico. La automatización no se trata de que “nunca falle”; se trata de que no te destruya cuando falle.
El sexto error: ignorar datos maestros y gobierno de información (la raíz invisible del caos)
Automatización sin datos confiables es como navegar sin mapa. Ubicaciones mal definidas, unidades inconsistentes, SKU con dimensiones incorrectas, slotting “de memoria”, inventarios con desfases. Y luego viene la frase típica: “el sistema falla”. No: el sistema ejecuta lo que le das. Si el dato está mal, la ejecución será un error muy eficiente.
El efecto es devastador: errores de surtido, bloqueos, retrabajo, discrepancias y pérdida de confianza. Dirección lo ve como impacto directo en servicio y costo. El piso lo vive como hartazgo: “siempre falla”.
El antídoto es claro y no negociable: plan de limpieza y gobierno de datos antes del go-live, con dueños del dato en el negocio (no “TI” como cajón de sastre). La pregunta crítica es: “¿qué datos deben ser perfectos para que esto funcione?” Si no lo sabes hoy, lo vas a pagar mañana.
El séptimo error: diseñar sin escalabilidad (nacer al límite)
Presupuestos apretados y presión por retorno rápido: totalmente entendible. El problema es diseñar al 95-100% de utilización desde el día uno. Eso deja cero margen para crecimiento, variabilidad o nuevos negocios. En mercados volátiles, eso es un riesgo financiero.
La consecuencia llega rápido: en 12-18 meses el sistema queda chico y empieza la era de los parches: turnos extra, rutas improvisadas, compras no planeadas o un segundo proyecto… más caro.
Desde diseño, la salida es modularidad: expansión por etapas, capacidad escalable y layout preparado. Y algo muy ejecutivo: definir el “camino de crecimiento” como parte del caso (capex futuro previsto). No es gastar de más; es proteger la inversión.
El octavo error: dejar la integración y la ciberseguridad “para el final”
Una automatización moderna no es un equipo: es un ecosistema. WMS/WES/WCS, PLCs, redes industriales, sensores, APIs, ERP y tableros. Cuando integración y seguridad se tratan al final, el proyecto se vuelve una negociación eterna entre proveedores y el riesgo operativo crece silenciosamente.
Eso termina en retrasos, sobrecostos, arranques fallidos y vulnerabilidades. Y cuando aparece un incidente, el diagnóstico es lento por una razón simple: nadie sabe dónde está el fallo, ni quién es responsable.
El diseño robusto define arquitectura de integración, responsables, pruebas FAT/SAT y criterios de validación desde el RFP. Además incorpora observabilidad: alarmas, logs, tableros y escalamiento. La pregunta que cambia el juego es: “¿quién integra qué y cómo se valida extremo a extremo?” Si no está escrito, estás apostando.
El diseño no es un gasto; es la póliza de seguro del ROI
En automatización, lo caro no es invertir; lo caro es invertir sin diseño. Un diseño meticuloso reduce el riesgo financiero, acelera el retorno, evita puntos únicos de falla y construye una operación que realmente se adopta. Además, protege un activo interno que pocas veces se cuantifica: la reputación del proyecto. Cuando la automatización funciona, se gana confianza y se abren puertas para escalar.
Por eso en DEVA, nos aseguramos de que nuestros socios comerciales antes de comprometer capital, realicen una evaluación preliminar de diseño: diagnóstico de procesos, limpieza de datos, análisis de picos, layout, arquitectura tecnológica, mantenimiento y escalabilidad. Es el paso más corto para evitar el camino más caro.
Si tu automatización falla por una semana, ¿tu operación tiene un plan diseñado para seguir funcionando… o dependerá de héroes, parches y horas extra?
¿Listo para optimizar tu almacén?
Habla con un experto DEVA y recibe una asesoría personalizada sin costo.